핵심 요약
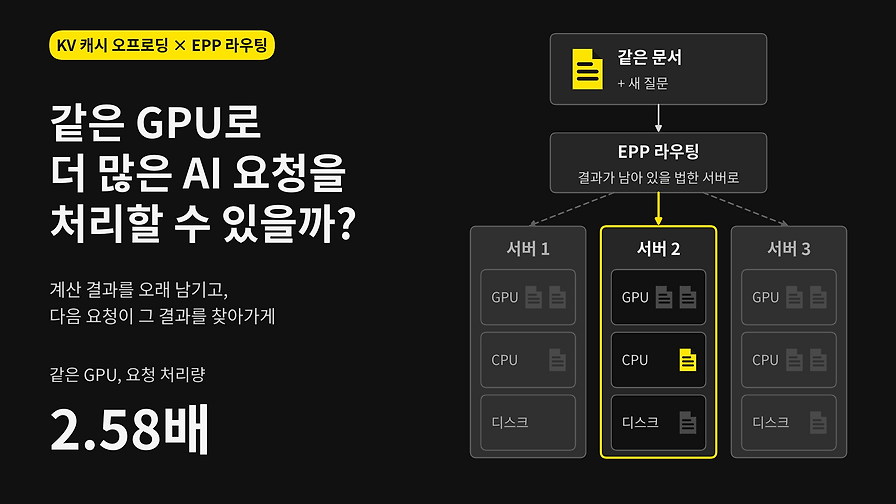
카카오가 같은 GPU 32장 환경에서 같은 모델과 GPU를 유지한 채 KV 캐시 오프로딩과 EPP 라우팅을 도입해 계산 결과를 GPU 밖에 저장하고, 다음 요청이 그 결과를 가진 서버로 가도록 하여 추론 처리량을 높였습니다.
구현 방법
- KV 캐시 오프로딩으로 계산 결과를 GPU 밖에 보관
- EPP 라우팅으로 같은 문서를 묻는 다음 요청이 해당 결과를 가진 서버로 전달되도록 구현
- 사내 LLM 추론 플랫폼의 게이트웨이 및 GPU 경로를 재설계
주요 결과
- 처리 시간 121.7분에서 47.2분으로 단축
- GPU 32장 및 모델은 변경 없이 유지
- 두 가지 변화로 결과 재사용 및 응답 흐름이 최적화