IT 기업 기술 블로그 모음
자동화 테스트부터 Perfetto 분석, 코드 개선안 도출까지 한 번에: 갤럭시 워치 성능 분석 AI 에이전트 개발기
Performance, SQL, Perfetto
삼성전자가 자동화 테스트에서 Perfetto 분석과 코드 개선안을 한 번에 도출하는 하이브리드 성능 분석 플랫폼 개발기를 다룹니다. 규칙 기반 재현, Perfetto SQL 전처리, 로컬 소스코드 매칭, 6종 AI 어드바이저를 결합한 접근으로 이슈 분석 리드타임을 1주에서 30분으로 단축했습니다. 홈 앱의 주요 시나리오에서 Janky Frame을 47.68% 개선한 결과와 구현 과정의 시행착오를 실무 포인트와 함께 상세히 공유합니다.
2026년 11월 12일·0
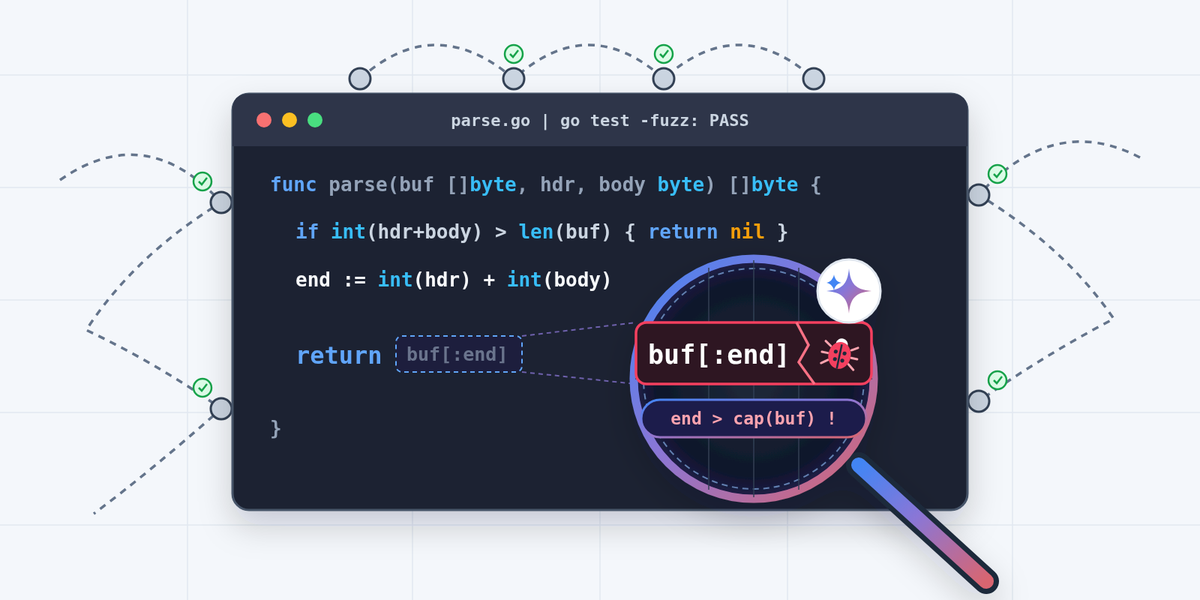
Catch Go bugs that fuzzing misses with Gemini and a constraint solver
Go, Gemini, Fuzzing, Constraint Solver
구글이 Go 코드의 남아 있는 경계 검사 트랩을 Gemini 4 Argon과 Z3 제약 솔버와 결합해 잠재적 경계 초과 패닉을 포착하는 방법을 소개합니다. Go 코드에서 잠재적 경계 초과 패닉을 포착하고 go test -fuzz의 슬라이스 용량 블라인드 스팟을 밝혀내는 구체적 방법과 분석 절차를 제시합니다. 이 연구를 통해 개발자는 퍼즈 테스트에서의 커버리지를 확장하고, 잠재적 오류를 조기에 해결하는 실무적 통찰을 얻을 수 있습니다.
2026년 11월 12일·0

How Agent Anomaly Detection scores on benchmarks we didn't write
Anomaly Detection, OpenTelemetry, Security, Observability, AI Agents
구글의 Agent Anomaly Detection(AAD)은 OpenTelemetry 트레이스와 로그를 분석하여 AI 에이전트의 목표 탈취와 도구 남용을 비동기식으로 모니터링합니다. 다섯 개의 공개 보안 벤치마크에서 테스트되어 해로운 지시의 87%를 런타임 지연 없이 포착했고, 정확도와 신뢰성 있는 성능을 보여줍니다. 개발자들은 시맨틱 거버넌스와 엄격한 도구 사용 제한과 함께 AAD를 방어-심층 전략의 일부로 통합하여 에이전트 기반 애플리케이션의 보안을 강화할 수 있습니다.
2026년 11월 12일·0
인텔리전트 아이웨어의 개인정보 보호 설계 원칙
Strategy, Innovation
구글코리아가 인텔리전트 아이웨어의 개인정보 보호 설계 원칙에 대해 다룹니다. 본 요약은 핵심 원칙과 실무 적용 시나리오를 가이드 형태로 제시하며, 현장 보안 고려사항과 개인정보 정책 연계 포인트를 함께 다룹니다.
2026년 11월 12일·0
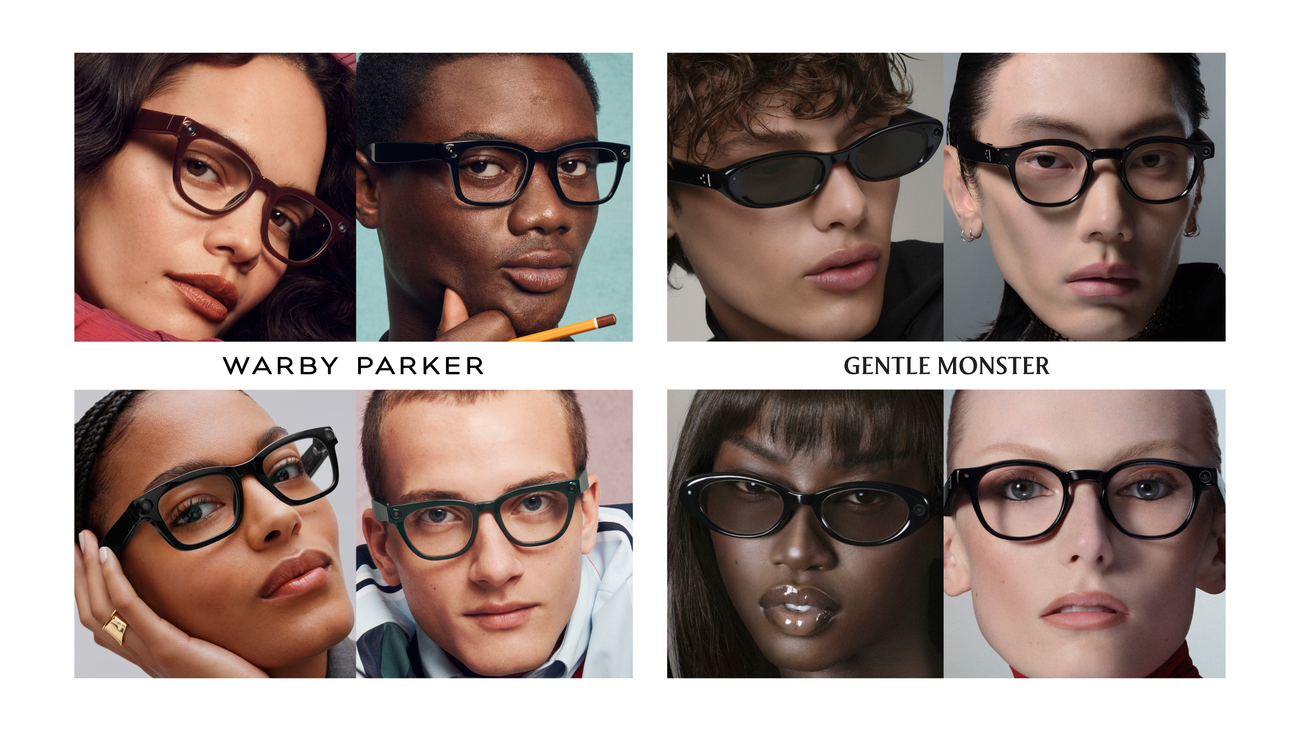
인텔리전트 아이웨어 라인업 공개 및 사전 예약 시작
Innovation, Event, Partnership, Product Launch
구글코리아가 인텔리전트 아이웨어 라인업 공개와 사전 예약 시작 소식을 발표합니다. 이 발표는 인텔리전트 아이웨어 카테고리에 대한 개요를 제시하고, 파트너 관계와 향후 개발 방향을 다룹니다.
2026년 11월 12일·0
데이터 사이언티스트 없이 수요 예측 자동화, 다이닝브랜즈그룹의 Amazon SageMaker Canvas 활용기
 AWS
AWS Lambda, Amazon RDS, Amazon S3, Amazon SageMaker Canvas, Amazon EventBridge Scheduler
AWS의 사례로 다이닝브랜즈그룹이 Amazon SageMaker Canvas를 활용해 데이터 사이언티스트 없이 수요예측 자동화를 구현한 아키텍처를 소개합니다. 데이터 수집에서 학습, 예측, 결과 반영까지를 자동화하고, Amazon RDS·S3·ECR·AWS Lambda와 EventBridge를 활용한 정기 파이프라인으로 시스템을 연결했습니다. 특히 세 모델 구성과 자동화된 발주 연계를 통해 신선계육 등 주요 품목의 재고 비용 절감과 품절 리스크 감소를 기대합니다.
2026년 11월 12일·0
KB증권 AI 에이전트는 어떻게 최적의 모델을 선택할까? – Amazon Bedrock 기반 Context Tier-Routing
AWSPython, Amazon SageMaker, Amazon ECS, Amazon Bedrock, Anthropic Claude Haiku
AWS가 제공하는 Amazon Bedrock 기반 Context Tier-Routing을 바탕으로 KB증권의 내부 에이전트 '깨비AI'의 최적 모델 선택 방식을 소개합니다. 질의 난이도와 에이전트 실행 상태를 반영해 각 LLM 호출마다 적합한 모델로 전환하고, Elevate-only 정책으로 불필요한 하향 전환을 방지하는 설계를 설명합니다. 실험 결과 품질을 유지하면서 토큰 사용량과 클라우드 호출 비용을 감소시키는 효과와 운영 시사점을 제시합니다.
2026년 11월 12일·0

[티빙 주간 추천작] 청춘들의 힐링 성장 드라마부터 웅장한 대하 사극까지!
Event, News, Television
티빙의 주간 추천작은 청춘의 힐링 성장 드라마와 웅장한 대하 사극을 아우르는 콘텐츠를 소개합니다. 이 주간 라인업은 다양한 장르를 통해 시청자에게 티빙의 콘텐츠 활용 가능성에 대한 경험을 공유합니다.
2026년 11월 12일·0

AV 3.0과 데이터 플라이휠: 자율주행의 승부처가 모델에서 데이터 파이프라인의 회전 속도로 옮겨 가는 이유 (1부)
AWSAWS, Amazon OpenSearch Service, NVIDIA Cosmos, NVIDIA Alpamayo, Amazon SageMaker HyperPod
AWS는 AV 3.0의 데이터 파이프라인 참조 아키텍처로 자율주행의 데이터 루프를 강조하고, Alpamayo·Cosmos 등 오픈 모델과 VLA 모델의 역할을 설명합니다. AWS는 8단계 데이터 파이프라인으로 Ingest, Data Processing, Train, Validate를 포함하고, 데이터 선택·재구성·증강·폐루프 검증을 연결하는 클라우드-투-카 흐름을 AWS SageMaker HyperPod, S3, Batch와 NVIDIA 도구로 구성합니다. 독자들은 AWS가 제공하는 관리형 파이프라인과 오픈 모델의 활용 가능성, 데이터 관리 전략, 긴 꼬리 문제 해결을 위한 시뮬레이션 접근을 참고할 수 있습니다.
2026년 11월 12일·0
LLM은 꼭 한 토큰씩 답해야 할까
 교보DTS
LLM, Latency, Diffusion Language Model, Token
교보DTS는 LLM의 응답 속도가 사용자 체감에 큰 영향을 준다는 점을 짚고, 한 토큰씩 응답해야 하는지 의문을 제기합니다. 대기 감소를 위해 모델 크기나 서버뿐 아니라 텍스트 생성 방식도 살펴볼 필요가 있으며, dLLM이 토큰을 병렬 예측하고 반복적으로 다듬는 접근을 시사합니다. 실무적으로는 텍스트 생성 전략의 최적화가 대기 시간을 줄이고 응답 품질을 유지하는 데 기여할 수 있음을 제시합니다.
2026년 11월 12일·1