Moait
홈인기 피드모든 블로그모든 태그
홈인기 피드모든 블로그모든 태그

TimeSeries Tiered Storage Journey: Kafka/Flink Streams to Native Cassandra Cold Reads

넷플릭스 favicon넷플릭스·Architecture·
Apache KafkaApache FlinkApache CassandraApache ParquetBloom Filters
2026년 10월 14일0

AI 요약

이 글은 AI가 요약했어요. 정확한 내용은 꼭 원문을 확인해 주세요!

핵심 요약

Netflix의 TimeSeries 아키텍처는 핫 데이터를 빠르게 유지하고, 오래된 데이터는 Kafka+Flink→S3와 Cassandra 백업 기반 콜드 스토리지로 이동시켜 읽기 지연과 스토리지 비용을 대폭 줄였습니다.

구현 방법

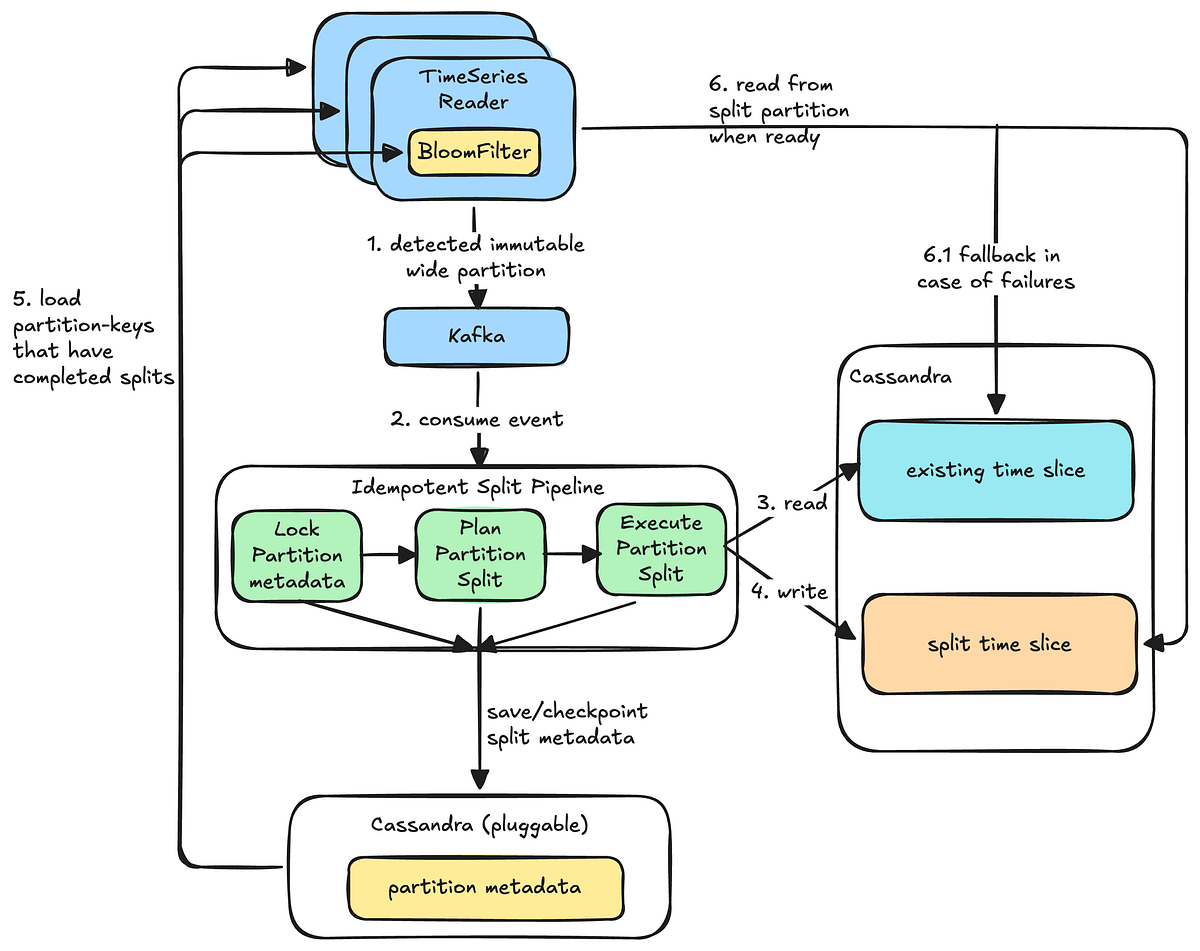
  • Time Slices/Immutable Windows로 파티션 및 메타데이터 관리
  • Kafka+Flink로 시간 단위 Parquet 파일 생성, Row Group 4–8MB, 이벤트 정렬, Bloom 필터 EVCache 활용
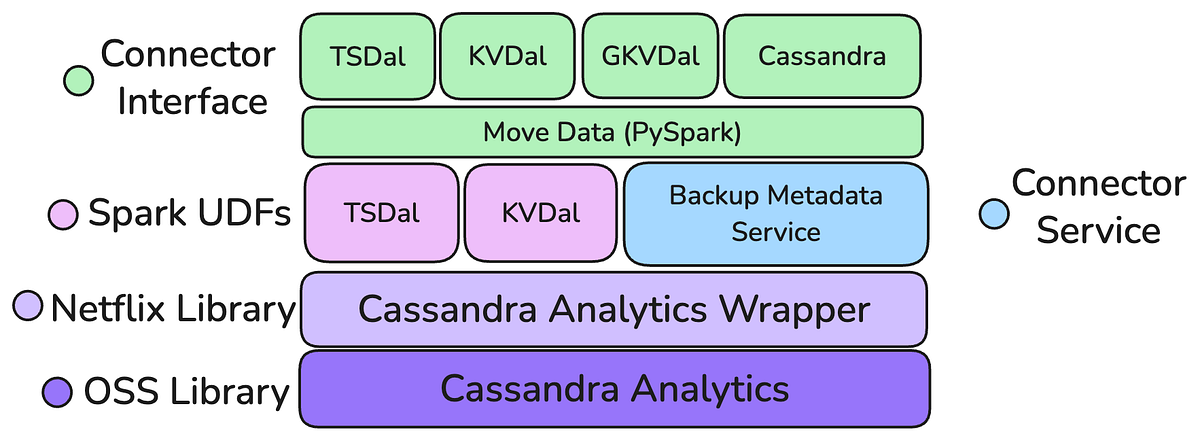
  • ROCS(ReadOnlyCompactionStrategy) 기반 백업 읽기 및 Memtable 초기화 자동화

주요 결과

  • p50 약 150ms, p99 약 500ms 읽기 지연
  • Cold tier에서 초당 최대 1,250건 읽기 처리
  • 총 저장 데이터 15PB 규모, 디스크 사용량 80%→7%로 절감
연관 피드

%가 높을수록 이 글과 비슷할 가능성이 높아요!
Dynamic Repartitioning for Time Series Workloads 섬네일
80%

Dynamic Repartitioning for Time Series Workloads

넷플릭스 favicon넷플릭스·2026년 06월 03일
Building Service Topology at Scale: Architecture, Challenges, and Lessons Learned 섬네일
73%

Building Service Topology at Scale: Architecture, Challenges, and Lessons Learned

넷플릭스 favicon넷플릭스·2026년 07월 13일
The Evolution of Cassandra Data Movement at Netflix 섬네일
73%

The Evolution of Cassandra Data Movement at Netflix

넷플릭스 favicon넷플릭스·2026년 06월 19일